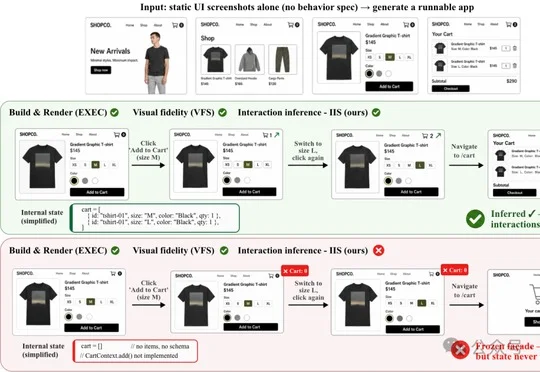
港科广新基准:只给截图,AI能把App交互做出来吗?
港科广新基准:只给截图,AI能把App交互做出来吗?港科广新基准UI2App以600张静态截图评测模型推断并实现应用交互的能力,Gemini 3.1 Pro Preview以73.2分获视觉还原第一,但Claude Sonnet 4.6以36.8分居交互推断首位,跨页面状态仍是参评模型共同难点。
来自主题: AI技术研报
7119 点击 2026-10-24 13:43

 搜索
港科广新基准UI2App以600张静态截图评测模型推断并实现应用交互的能力,Gemini 3.1 Pro Preview以73.2分获视觉还原第一,但Claude Sonnet 4.6以36.8分居交互推断首位,跨页面状态仍是参评模型共同难点。
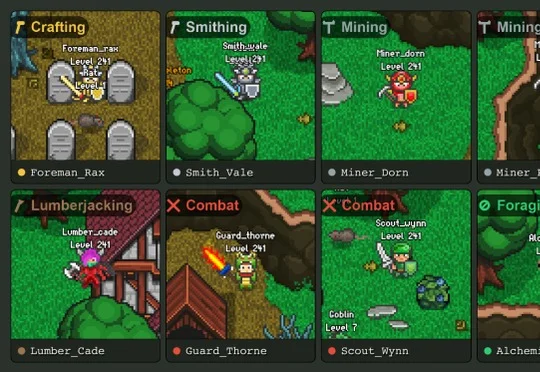
OpenAgents、哥伦比亚大学等研究者构建多智能体协作评测基准AgentWorld,评测显示主任务最高完整成功率为Gemini 3 Flash的52.0%,并提出CCE指标分析协作贡献。
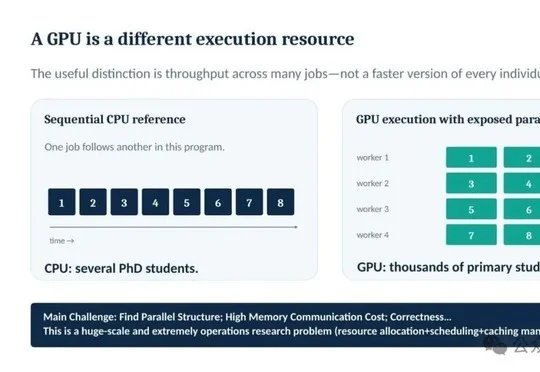
港科大团队在NeurIPS 2026上提出AccelEval基准,覆盖6个领域42项任务和43类CUDA优化策略,评测大模型能否从可信CPU程序生成端到端更快的GPU实现,其中Gemini 3.1 Pro在中规模通过正确性验证的任务上取得71.2倍几何平均加速比。
Insilico Medicine、Liquid AI、巴克衰老研究所等机构在Cell发表论文,推出面向衰老研究的AI工具链LongevityBench、Longevity-LLMs和Longevity Claw,其中参数量仅9B的专用模型L-Qwen3.5-9B在综合排名中超越Gemini 3.1 Pro和Claude Opus 4.6。
谷歌又杀回来了。
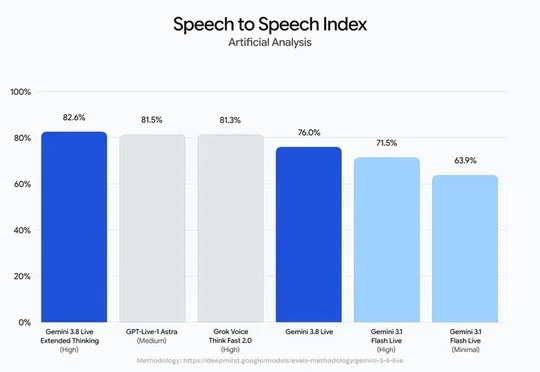
谷歌发布 Gemini 3.8 Live 与 Gemini 3.8 Live Extended Thinking 两款实时语音模型,后者支持后台异步推理与工具调用以解决语音 Agent 在任务执行中的沉默问题,两款模型已在 Gemini API 和 Google AI Studio 向开发者开放。
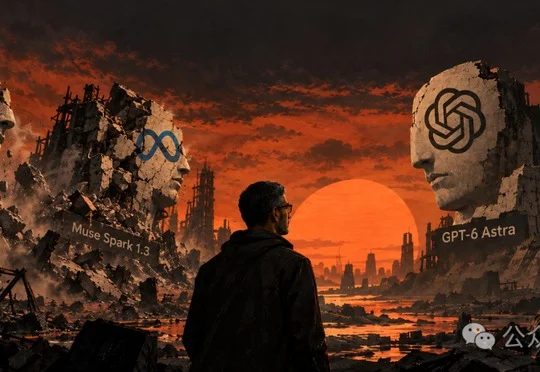
分析机构SemiAnalysis点名谷歌Gemini 3.8 Flash和Meta Muse Spark 1.3在Terminal-Bench 2.1刷榜,换用新版Terminal-Bench 4.0后Gemini分数从89.4暴跌至19.1,揭露大厂通过购买"模拟卷"训练数据刷榜的AI造假黑幕。
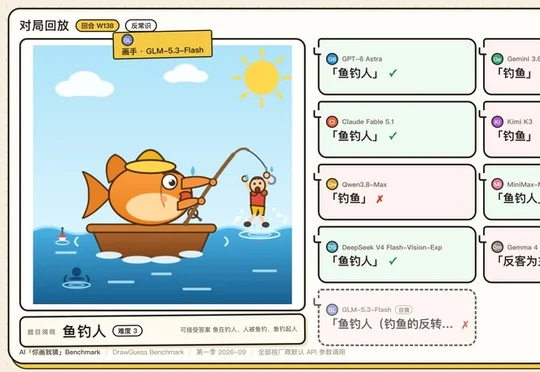
我们自建的"你画我猜 Benchmark"第一期用150个词、1350张SVG画作对8款模型进行互画互猜测试,最终GPT-6 Astra以75.5分险胜Gemini 3.8 Flash与Claude Fable 5.1,结果显示思考更多或花费更多的模型并未稳定取得更高分,且部分模型连自己的画都认不出。
谷歌Antigravity团队公布Teamwork多智能体编排框架成果,轻量级Gemini 3.7 Flash复现了Gemini 3.1 Pro解出的3道博士级数学难题,并从零构建RISC-V CPU模拟器、改进Eigen和ParlayHash开源库代码,证明小模型通过制度化博弈编排也能完成顶尖科研与工程任务。
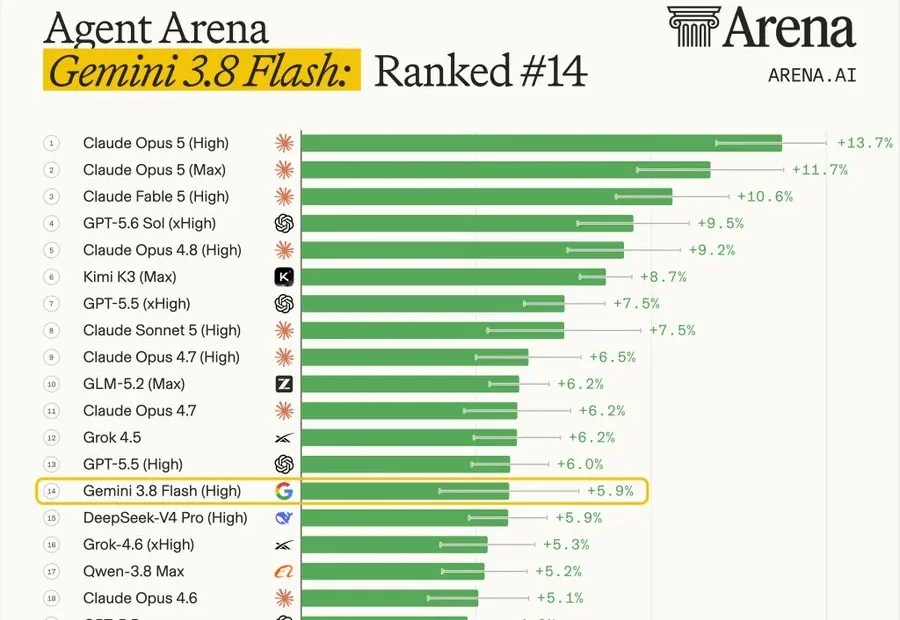
刚刚,Gemini 3.8 Flash,正式发布。